
새 기능 · SEED SCORE 63
Amazon SageMaker AI의 Mixture-of-Experts 커널 최적화
3줄 요약
- AWS 엔지니어들이 Mixture-of-Experts 모델을 위한 커널 최적화를 발표했다.
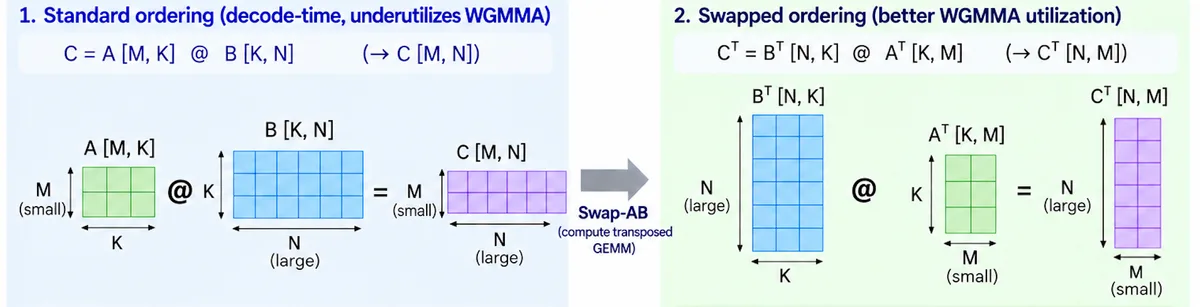
- 이 최적화는 Swap-AB, Triton 백엔드 라우팅, JIT 재컴파일 제거를 포함한다.
- H200 GPU에서 처리량은 최대 10%, 첫 토큰 생성 시간은 최대 9% 개선되었다.
무슨 일이 생겼나요?
Amazon SageMaker AI에서 Mixture-of-Experts 모델의 성능을 높이기 위한 커널 최적화가 적용되었다.
왜 중요한가요?
이 최적화는 대규모 AI 모델의 처리 효율과 응답 속도를 개선하여 실무에서 모델 운영 비용과 시간을 줄일 수 있다.
한국 실무자는 어디에 쓸 수 있나요?
한국 내 AI 서비스 운영 시 SageMaker AI를 활용한다면 모델 처리 속도와 효율이 향상되어 경쟁력 강화에 도움이 될 수 있다.
내 역할에 미치는 영향
대표·운영자
AI 서비스 운영 비용 절감과 처리 속도 개선을 위해 SageMaker AI 최적화 적용을 검토해야 한다.
개발자
Mixture-of-Experts 모델 개발 시 최적화된 커널 활용으로 성능 개선 가능성을 확인하고 적용 방안을 모색해야 한다.
마케터
향상된 처리 속도를 바탕으로 AI 서비스의 신속성과 효율성을 강조하는 마케팅 전략을 수립할 수 있다.
일반 사용자
SageMaker AI의 최신 최적화 기능을 이해하고, 모델 학습 및 추론 작업에 미치는 영향을 파악해야 한다.
지금 할 수 있는 행동
- AWS 공식 문서를 참고하여 최적화된 커널 기능을 상세히 검토한다.
- 자사 AI 모델에 해당 최적화를 적용할 수 있는지 기술적 검토를 진행한다.
- 성능 개선 효과를 테스트 환경에서 직접 측정하여 도입 여부를 결정한다.
확인한 사실과 해석
확인한 사실 · Mixture-of-Experts 모델의 처리량이 최대 10% 증가했다.
확인한 사실 · 첫 토큰 생성 시간이 최대 9% 단축되었다.
왜 이 점수인가요?
사실 확인 수준. 공식 원문 확인
| 항목 | 점수 | 최대 배점 |
|---|---|---|
| 출처 신뢰도 | 15 | 15 |
| 최신성 | 10 | 10 |
| 독립 출처 확인 | 0 | 10 |
| 관심도 증가 | 0 | 10 |
| 한국 실무 영향 | 14 | 20 |
| 활용 가능성 | 12 | 15 |
| 새로움 | 3 | 5 |
| 대응 시급성 | 9 | 15 |
| 총점 | 63 | 100 |
- AI 모델 성능 개선은 실무 효율성에 직접적 영향을 준다.
- SageMaker AI는 국내에서도 활용 가능한 클라우드 서비스다.
- 최적화 기술이 최신 GPU 환경에 맞춰져 있어 실용적이다.
- 관심도 증가는 비교 가능한 최근 관측이 없어 0점으로 처리했습니다.
- 공식 원문으로 확인했습니다.