
새 기능 · SEED SCORE 57
vLLM의 양방향 KV 캐시 전송으로 다중 턴 에이전트 작업의 첫 토큰 지연 시간 개선
3줄 요약
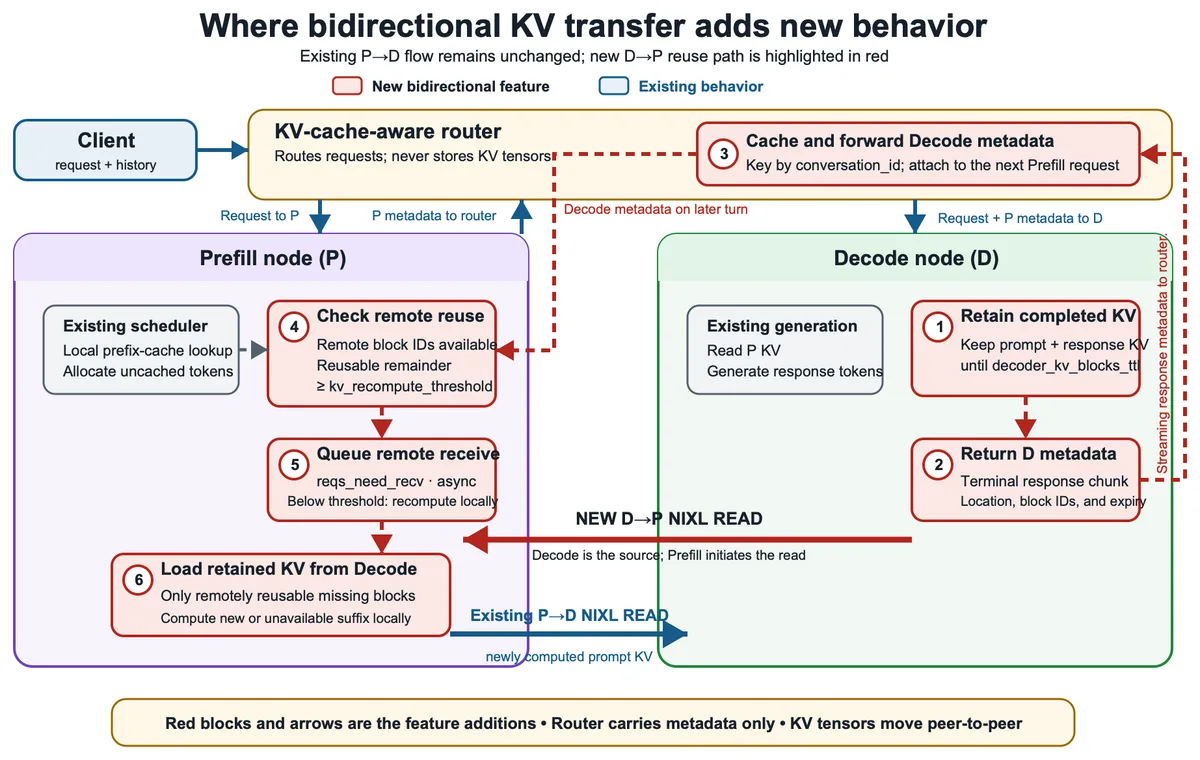
- vLLM은 다중 턴 대화에서 이전에 계산된 컨텍스트를 재사용하는 양방향 KV 캐시 전송 기능을 도입했다.
- 이 기능은 Qwen3-32B 모델에서 첫 토큰 생성 시간을 최대 1.6배, GLM-5-FP8 모델에서는 최대 3.3배 단축시킨다.
- Amazon EC2 P5en 인스턴스와 EFA 환경에서 성능 향상이 확인되었다.
무슨 일이 생겼나요?
vLLM이 다중 턴 에이전트 작업에서 컨텍스트 재처리로 인한 지연을 줄이기 위해 양방향 KV 캐시 전송 기능을 추가했다.
왜 중요한가요?
대화형 AI의 응답 속도가 빨라져 사용자 경험이 개선되고, 클라우드 자원 사용 효율도 높아질 수 있다.
한국 실무자는 어디에 쓸 수 있나요?
한국 내 AI 서비스 개발 시 다중 턴 대화 처리 성능 향상에 기여할 수 있으나, 직접적인 한국어 지원 여부는 확인되지 않았다.
내 역할에 미치는 영향
대표·운영자
서비스 지연 감소로 사용자 만족도가 향상될 가능성이 있어 운영 효율 개선에 집중해야 한다.
개발자
양방향 KV 캐시 전송 기능을 이해하고 적용해 다중 턴 대화 모델의 응답 속도를 최적화해야 한다.
마케터
성능 개선 사례를 활용해 대화형 AI 서비스의 신뢰성과 속도 강점을 홍보할 수 있다.
일반 사용자
새 기능 도입으로 대화형 AI 응답 시간이 줄어들어 업무 효율성이 높아질 수 있음을 인지해야 한다.
지금 할 수 있는 행동
- vLLM의 양방향 KV 캐시 전송 기능 적용 가능성을 검토한다.
- 다중 턴 대화 모델의 응답 속도 개선 효과를 테스트 환경에서 확인한다.
- 성능 개선이 실제 서비스에 미치는 영향을 평가하고 도입 계획을 수립한다.
확인한 사실과 해석
확인한 사실 · 양방향 KV 캐시 전송은 Qwen3-32B 모델에서 첫 토큰 생성 시간을 최대 1.6배, GLM-5-FP8 모델에서 최대 3.3배 단축시킨다.
왜 이 점수인가요?
사실 확인 수준. 공식 원문 확인
| 항목 | 점수 | 최대 배점 |
|---|---|---|
| 출처 신뢰도 | 15 | 15 |
| 최신성 | 9 | 10 |
| 독립 출처 확인 | 0 | 10 |
| 관심도 증가 | 0 | 10 |
| 한국 실무 영향 | 10 | 20 |
| 활용 가능성 | 11 | 15 |
| 새로움 | 3 | 5 |
| 대응 시급성 | 9 | 15 |
| 총점 | 57 | 100 |
- 다중 턴 대화 처리 지연 감소는 AI 서비스 품질에 직결된다.
- 한국 내 AI 서비스에 직접 적용 가능성은 있으나 구체적 지원 정보는 부족하다.
- 클라우드 인프라 환경에서 성능 최적화에 실질적 도움이 된다.
- 관심도 증가는 비교 가능한 최근 관측이 없어 0점으로 처리했습니다.
- 공식 원문으로 확인했습니다.