
새 기능
OpenAI의 Codex Ultrafast로 사고 조사 시간 단축
OpenAI 엔지니어들이 Codex Ultrafast를 활용해 사고 조사를 몇 시간에서 몇 분으로 단축했다.
출처 기반 AI 분석 · 매일 자동 업데이트
OpenAI 엔지니어들이 Codex Ultrafast를 활용해 사고 조사를 몇 시간에서 몇 분으로 단축했다.
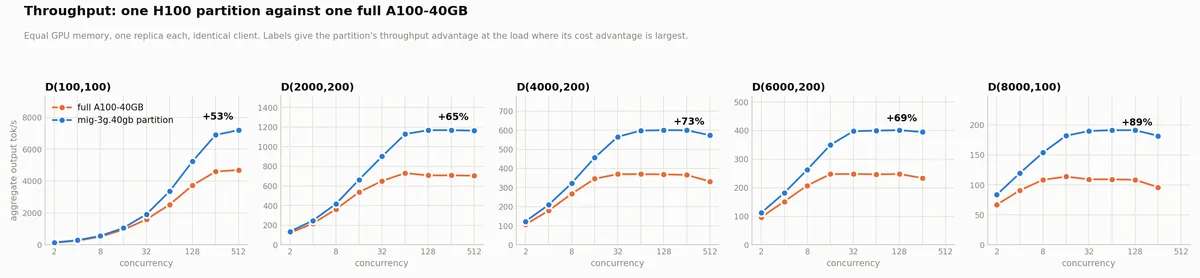
Amazon SageMaker Inference가 NVIDIA Multi-Instance GPU(MIG)를 지원하여 하나의 GPU를 여러 하드웨어 격리 파티션으로 나눌 수 있다.
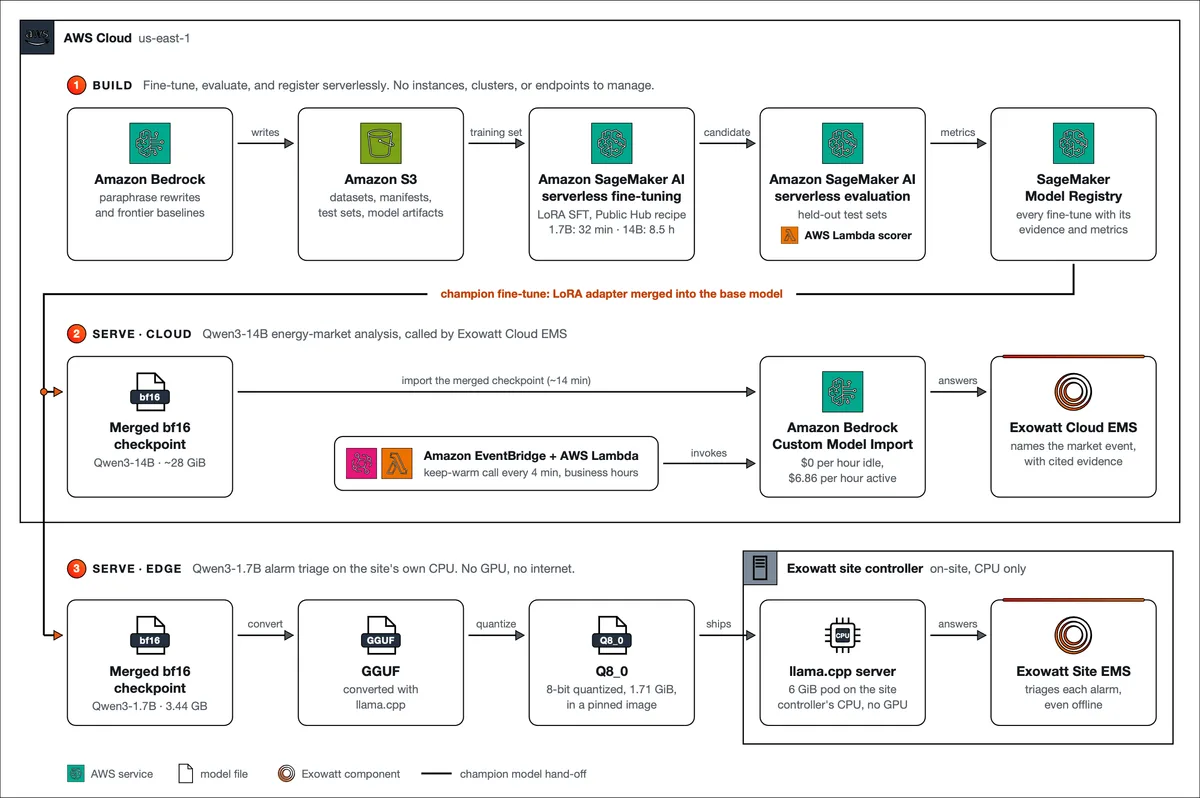
Exowatt는 Amazon SageMaker의 서버리스 AI 맞춤형 기능을 활용해 특정 작업에 최적화된 모델을 개발했다.
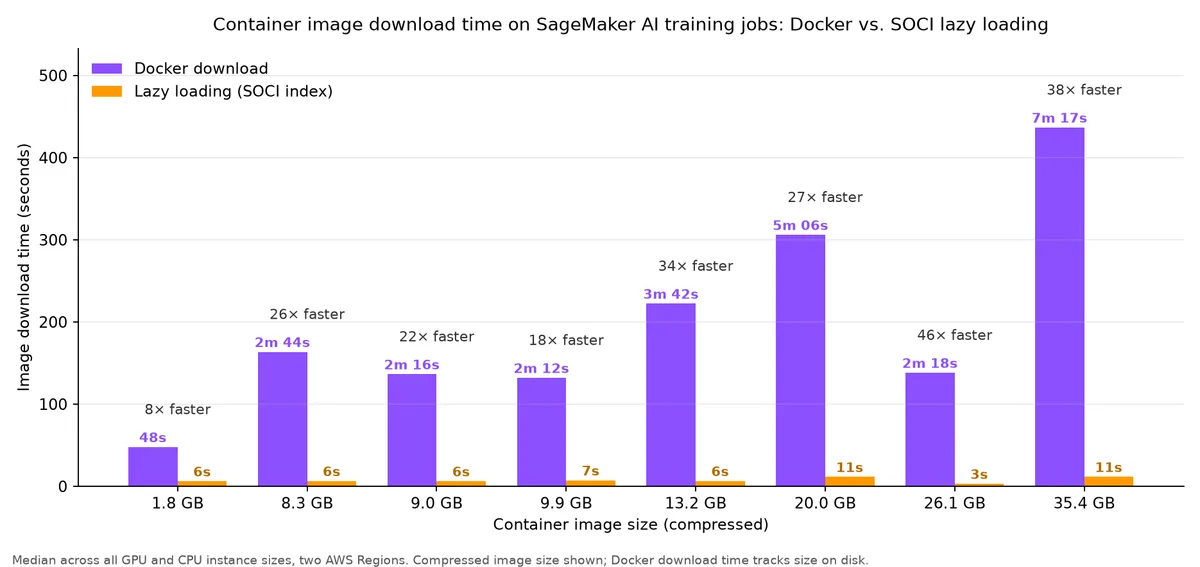
Amazon SageMaker가 SOCI 인덱스 이미지를 도입해 AI 학습 및 처리 작업의 컨테이너 이미지 다운로드 시간을 단축했다.
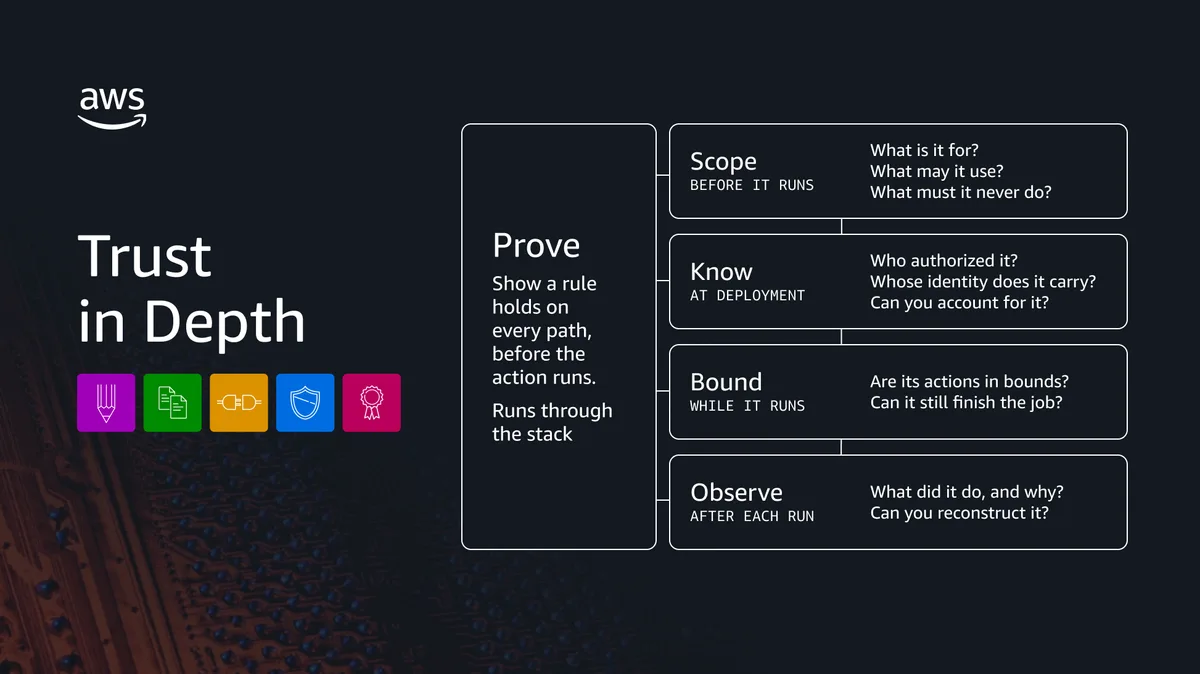
AWS는 AI 에이전트가 더 많은 업무를 수행하도록 하면서도 신뢰를 유지하는 다층적 접근법인 Trust in Depth를 발표했다.
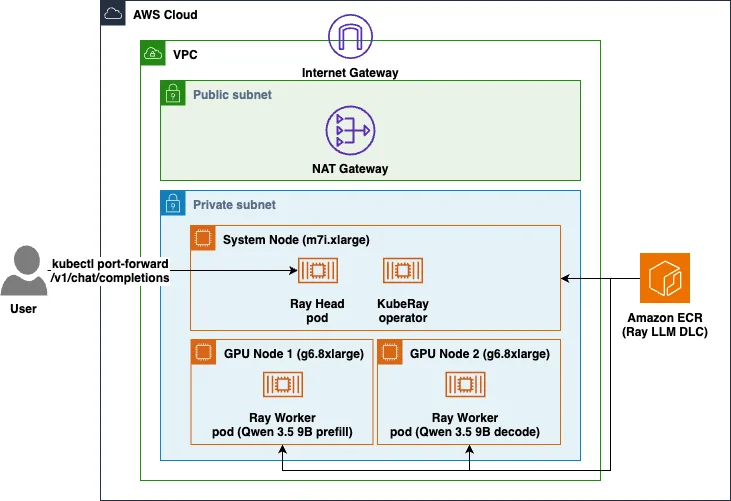
Ray LLM Deep Learning Containers를 통해 하나의 대형 언어 모델을 두 개의 GPU 노드에 분산 배포할 수 있다.
Gemini Omni 1.2 Flash는 15초 길이의 영상 생성과 편집을 기본 지원한다.
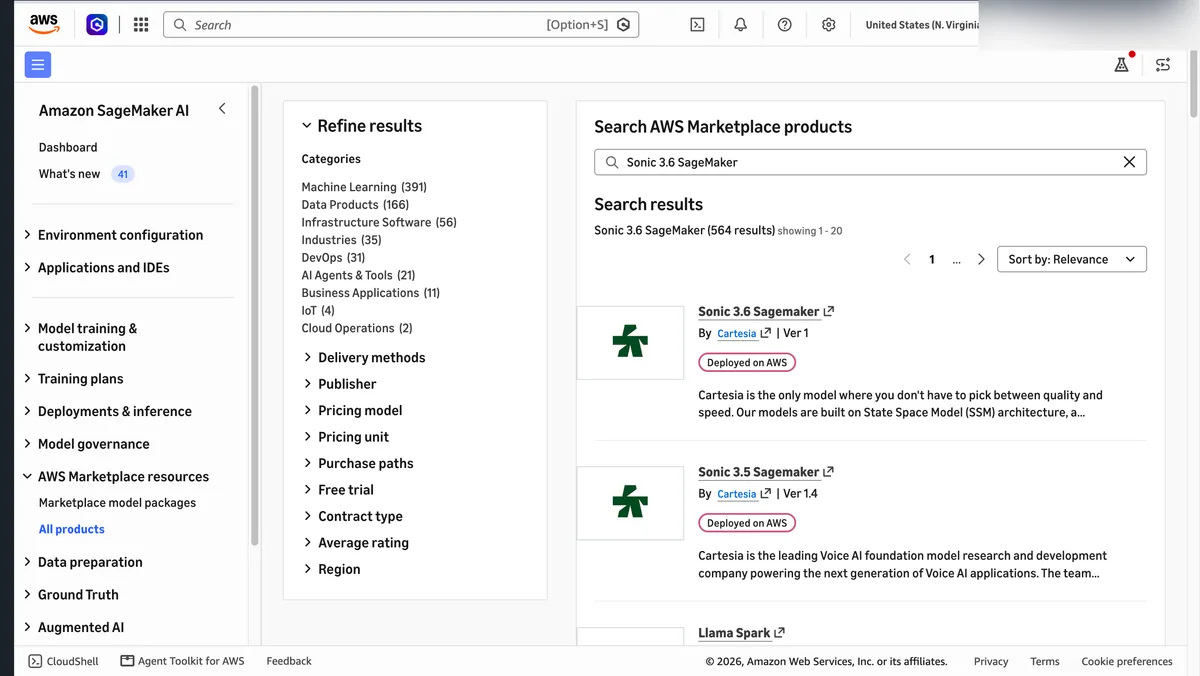
Cartesia는 AWS 인프라와 특화된 상태 공간 모델을 활용해 100ms 이하의 텍스트-음성 및 음성-텍스트 변환을 구현한다.
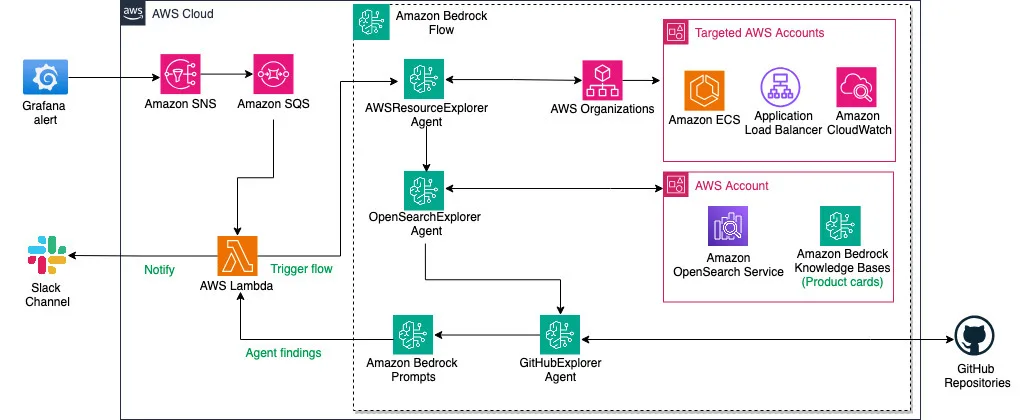
Circle K의 DevOps 팀은 Amazon Bedrock을 활용해 사고 분류 시간을 기존 45~60분에서 15분 이하로 줄였다.
AWS Batch가 SageMaker Training 작업을 위한 쿼터 관리 기능을 도입했다.
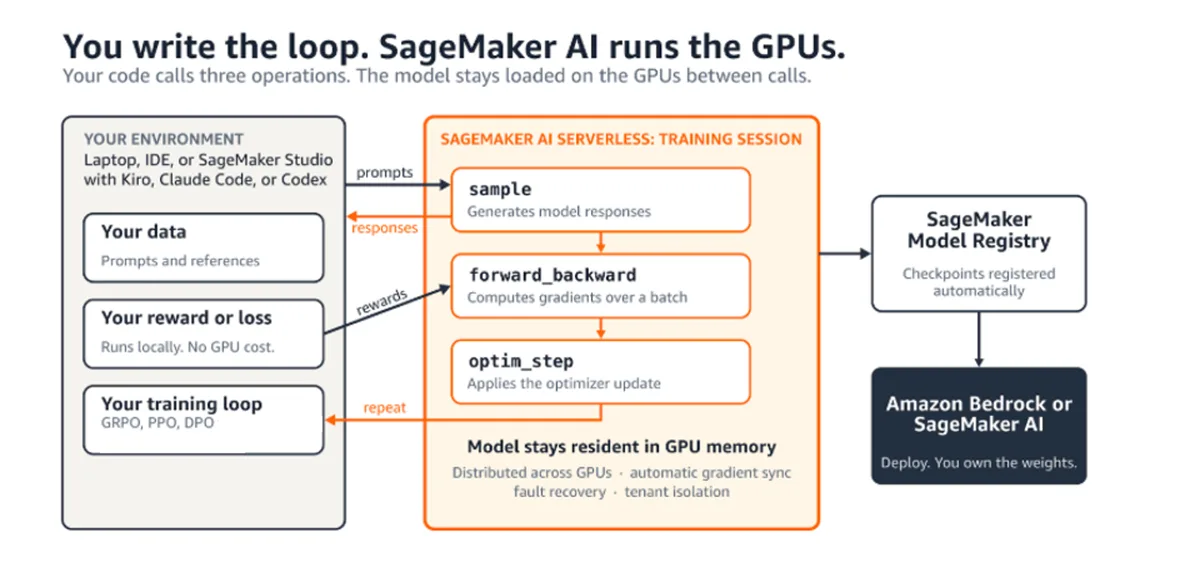
Amazon SageMaker AI가 GPU 관리 없이 모델 커스터마이징을 지원하는 서버리스 훈련 세션을 정식 출시했다.
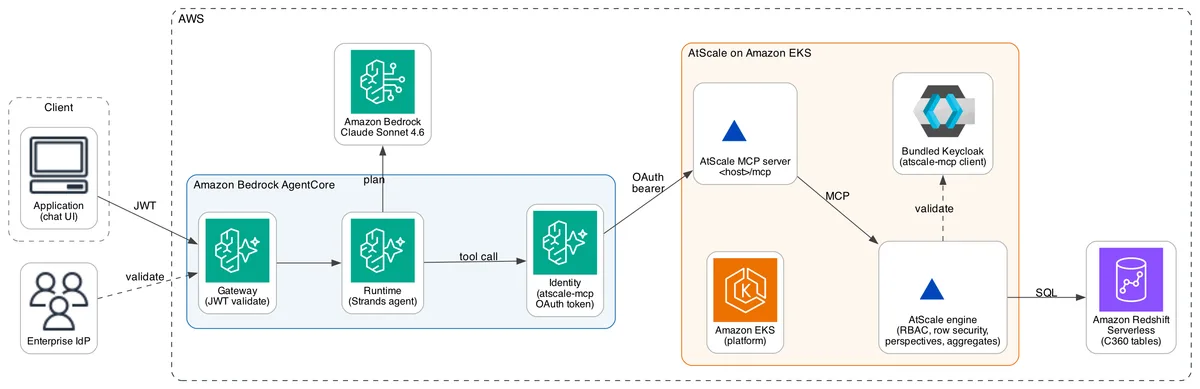
AWS는 AtScale과 Amazon Bedrock AgentCore를 결합해 고객 360 모델에 대한 시맨틱 레이어를 구축하는 기능을 발표했다.
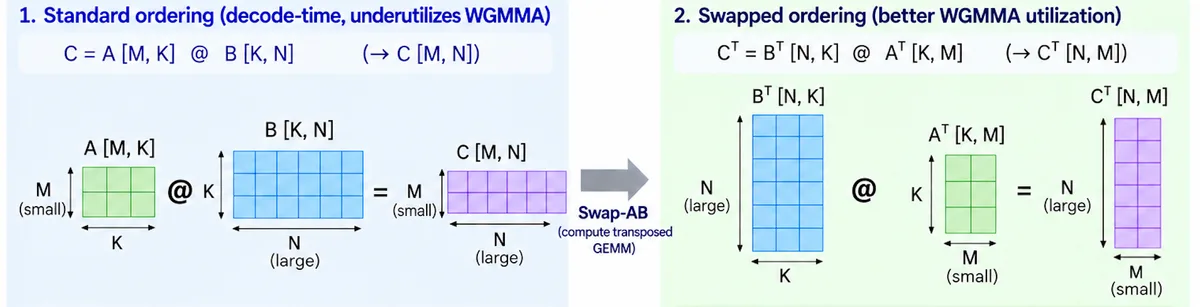
AWS 엔지니어들이 Mixture-of-Experts 모델을 위한 커널 최적화를 발표했다.
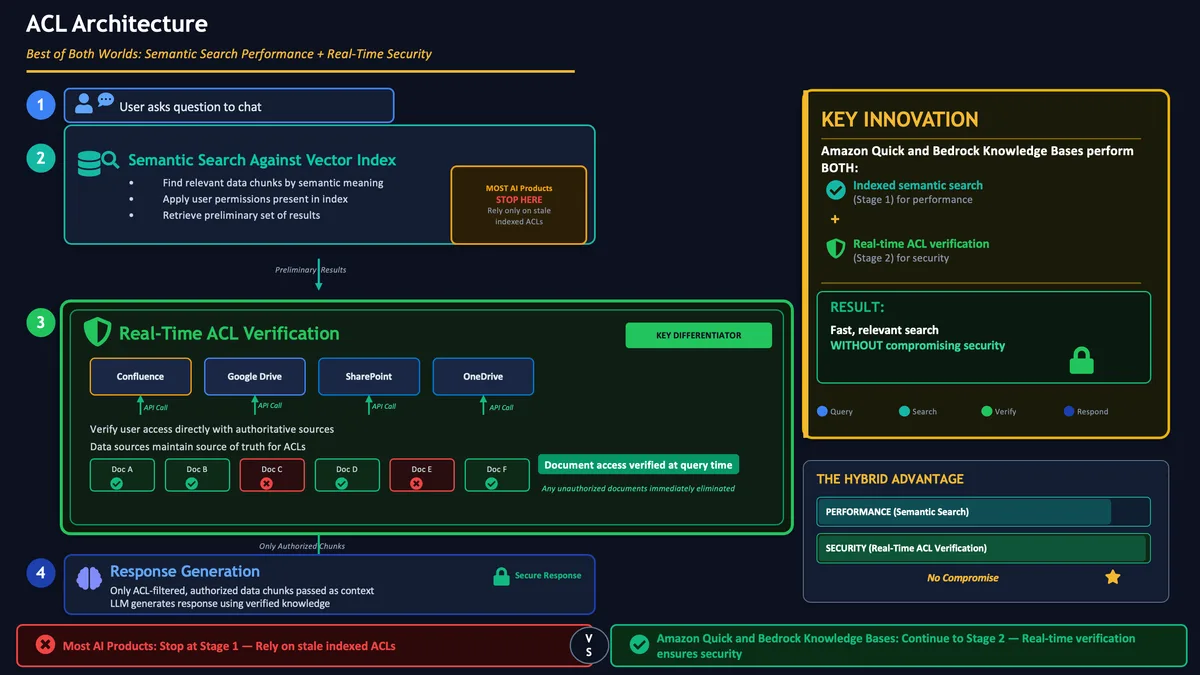
Amazon Quick와 Amazon Bedrock은 SharePoint, Google Drive, Confluence 같은 지식 소스의 복잡한 권한을 실시간으로 검증하는 문서 수준 접근 제어 기능을 제공한다.
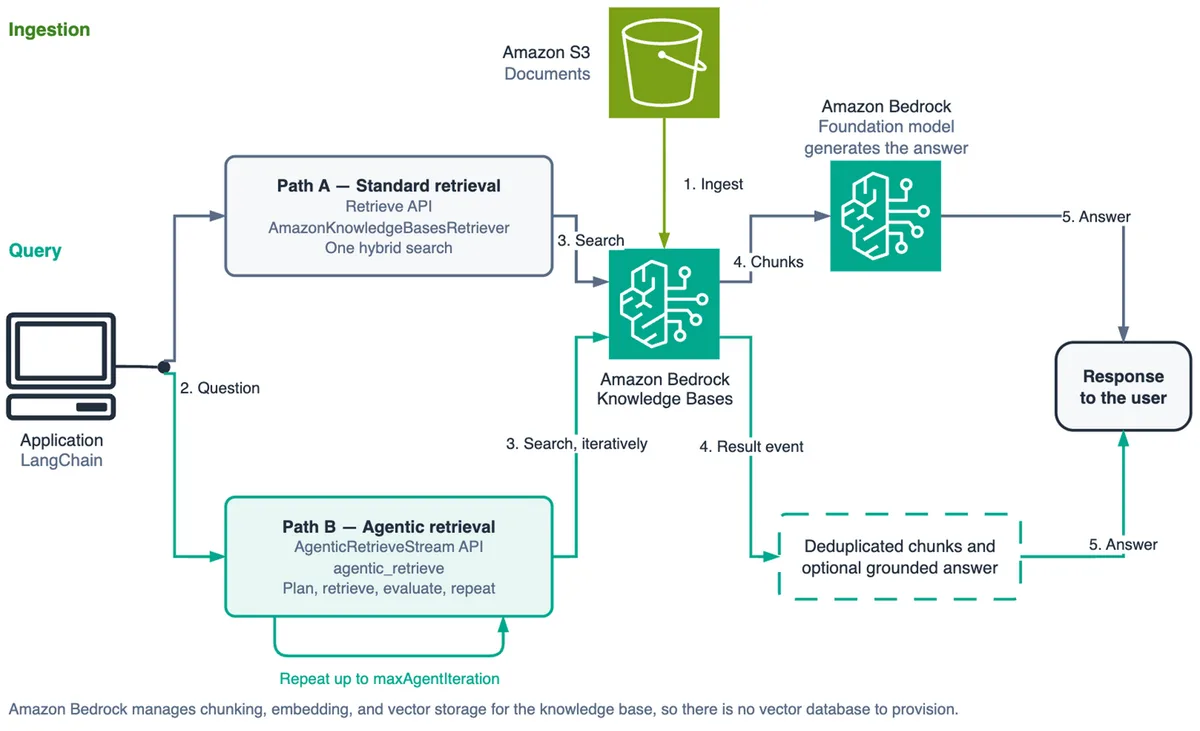
Amazon Bedrock 관리형 지식 기반과 LangChain을 이용해 RAG 애플리케이션을 구축할 수 있다.